阅读提要
限流算法有四种,选错的代价不是慢,而是「该拦的没拦住」。这篇从固定窗口的边界问题讲起,给出滑动窗口的两种实现和分布式下的正确做法。
先看固定窗口错在哪
最朴素的限流是按分钟计数:每分钟最多 100 次,到点清零。
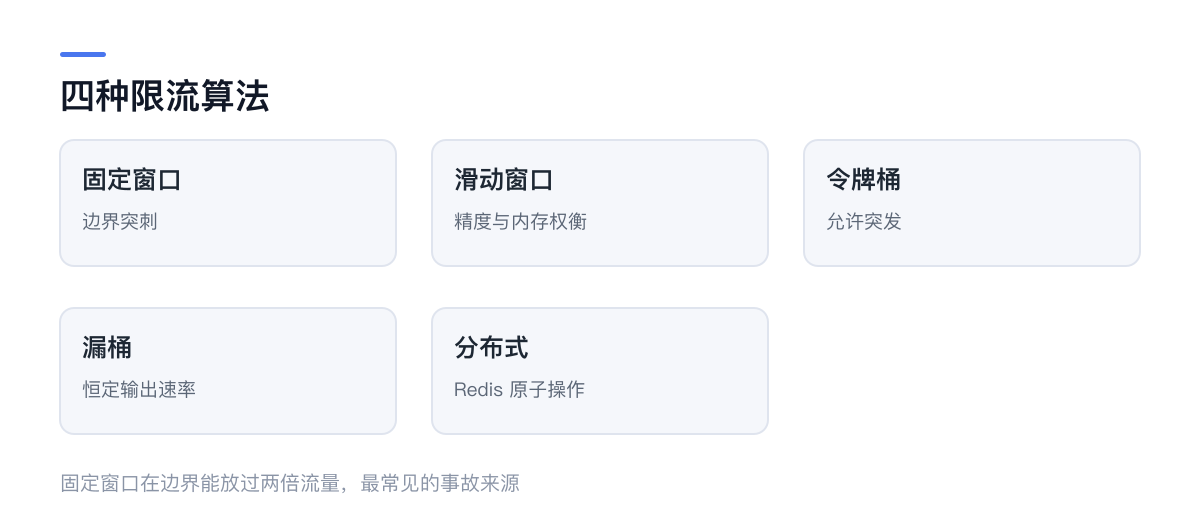
代码简单,问题致命:如果攻击者在第 59 秒打 100 次,第 61 秒再打 100 次,两个窗口各 100 次都合规,但实际两秒内过了 200 次。这就是窗口边界突刺。
对登录接口、短信验证码这类场景,这个突刺足以造成实际损失。
滑动窗口:把「一分钟」变成「最近 60 秒」
滑动窗口的核心变化是:不再按自然分钟切分,而是以「当前时刻往前推 60 秒」为窗口。
最精确的实现是记录每次请求的时间戳,查询时统计窗口内的数量:
const hits = new Map()   // key -> number[]

function allow(key, limit = 100, windowMs = 60_000) {
  const now = Date.now()
  const list = (hits.get(key) || []).filter(t => now - t < windowMs)
  if (list.length >= limit) {
    hits.set(key, list)
    return false
  }
  list.push(now)
  hits.set(key, list)
  return true
}
精确,但内存开销随请求量线性增长。一个用户一分钟 100 次请求,十万活跃用户就是千万级时间戳。单机内存扛不住。
折中方案:分桶计数
把 60 秒切成 6 个 10 秒的桶,每次请求只给当前桶加一,统计时把最近 6 个桶的计数加起来。
function allow(key, limit = 100, windowMs = 60_000, buckets = 6) {
  const size = windowMs / buckets
  const now = Date.now()
  const slot = Math.floor(now / size)
  const record = hits.get(key) || { slot, counts: new Array(buckets).fill(0) }

  // 跨桶时滚动数组,把过期桶清零
  if (record.slot !== slot) {
    const shift = Math.min(slot - record.slot, buckets)
    record.counts = [...new Array(shift).fill(0), ...record.counts.slice(0, buckets - shift)]
    record.slot = slot
  }

  const total = record.counts.reduce((a, b) => a + b, 0)
  if (total >= limit) {
    hits.set(key, record)
    return false
  }
  record.counts[buckets - 1] += 1
  hits.set(key, record)
  return true
}
内存恒定(每个 key 一个定长数组),精度损失最多一个桶的量级。把桶切细到 60 个 1 秒桶,误差就基本可以忽略。
这是工程上最常用的做法。它的精度不是「精确」,但足够拦住绝大多数刷接口行为,而且不会因为限流本身把服务拖垮。
令牌桶与漏桶解决的是另一类问题
前面两种都在控制「一段时间内的总量」。令牌桶和漏桶控制的是「速率」。
令牌桶:以固定速率往桶里放令牌,桶有容量上限。请求消耗令牌,没令牌就拒绝。它的特点是允许突发——桶里攒了 10 个令牌,就能瞬间放行 10 个请求。适合「平时很闲、偶尔密集」的场景,比如用户手动触发的批量操作。
漏桶:请求先进队列,以固定速率流出。它不允许突发,输出速率恒定。适合保护下游——比如你调用第三方 API,对方限制每秒 5 次,用漏桶排队比直接拒绝更友好。
选哪个取决于你要保护谁:保护自己不被刷,令牌桶;保护下游不被打爆,漏桶。
分布式下必须用原子操作
多实例部署时,内存计数各算各的,实际放行量是「单机限制 × 实例数」。
用 Redis 时,GET 再 SET 是错的——两个请求可能同时读到旧值。必须用原子命令:
-- 滑动窗口计数的原子版本
local key = KEYS[1]
local now = tonumber(ARGV[1])
local window = tonumber(ARGV[2])
local limit = tonumber(ARGV[3])
redis.call('ZREMRANGEBYSCORE', key, 0, now - window)
local count = redis.call('ZCARD', key)
if count >= limit then
  return 0
end
redis.call('ZADD', key, now, now .. '-' .. math.random())
redis.call('PEXPIRE', key, window)
return 1有序集合天然按时间排序,清理过期成员和计数都是一条命令。PEXPIRE 必须有,否则冷 key 会永久占内存。
这个脚本的代价是每个请求一次 Redis 往返。高频接口上,本地预检 + Redis 兜底的两级结构更划算:本地先挡明显超限的,剩下的才问 Redis。
参数怎么定
限流参数不该拍脑袋。三个问题:
- 正常用户一分钟会请求多少次?(取 P99,再乘 2)
- 被刷的时候,你能承受多少?(这是上限)
- 误伤一个正常用户的代价,和被刷爆的代价,哪个大?
第三个问题决定你把阈值设在哪。验证码接口宁可误伤也要严,文章列表接口宁可放宽也不该误拦。
一个最小的可用版本
如果不想上 Redis,先做这三件事就够挡住大部分问题:
- 按 IP + 用户 ID 双维度限流,任一超限即拒;
- 登录、注册、发评论这类写接口单独给更严的阈值;
- 拒绝时返回 429 并带
Retry-After,让客户端知道什么时候重试。
限流的目的不是「绝对精确」,是「把成本转嫁给攻击者」。算法够用就行,别为了精确度把正常请求也拖慢。
你认为这篇文章怎么样?
还没有表情反馈
一起聊聊
一个想法、一点补充,或一句简单的问候。
评论与回复
友善交流,彼此尊重第一句话,留给你。
读完有什么感受?欢迎成为第一个分享的人。