阅读提要
一个每天跑一次的任务,某天开始同时跑了五份,把数据库连接池耗尽。重叠执行不是「偶发故障」,是缺少互斥和超时的必然结果。
事故是这样发生的
一个「每小时清理过期缓存」的任务,平时跑 40 秒就结束。某天数据库变慢,单次跑到 25 分钟。
下一个整点,cron 照常触发,第二份开始跑。两份同时操作同一批数据,互相等待锁。第三个小时,三份。
到第六个小时,六份任务把连接池占满,正常请求拿不到连接,接口全线超时。
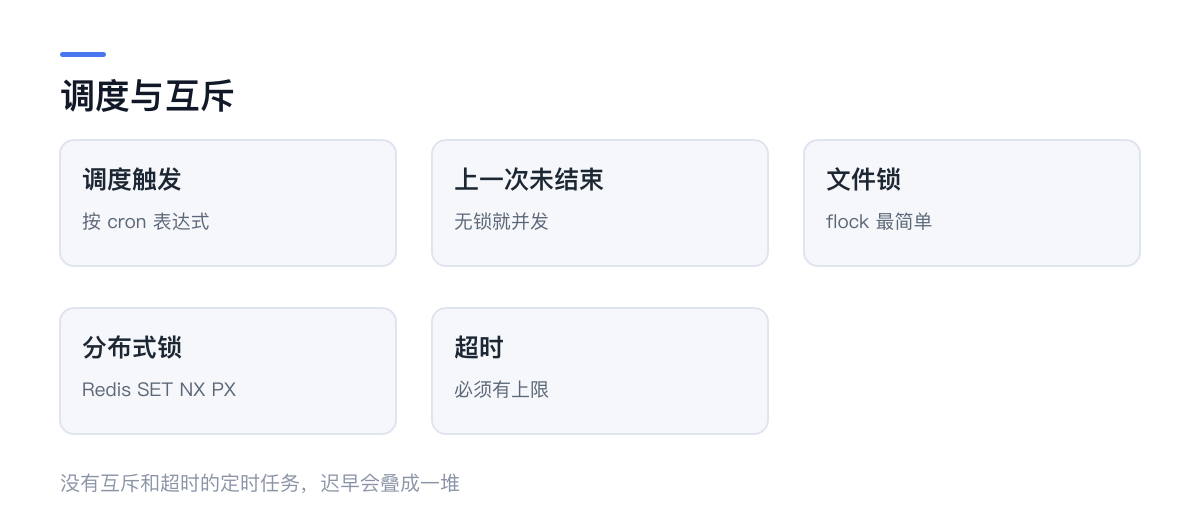
根因不是「数据库变慢」,而是任务没有互斥机制。cron 只负责按时触发,它不知道上一次有没有跑完。
第一层:进程内互斥
单机部署时,最简单的办法是加锁文件:
import { open } from 'node:fs/promises'

async function withLock(name, fn) {
  const path = `/tmp/${name}.lock`
  let handle
  try {
    handle = await open(path, 'wx')   // 排他创建,已存在则失败
  } catch {
    return { skipped: true }          // 上一轮还在跑
  }
  try {
    return { result: await fn() }
  } finally {
    await handle.close()
    await unlink(path).catch(() => {})
  }
}
open 用 wx 标志是关键:文件存在就抛错,这一步是原子的。不要用「先 existsSync 再创建」,那是竞态。
锁文件的弱点:进程被 kill -9 时文件残留,下一轮永远跳过。所以要么记录 PID 并检查进程是否存活,要么给锁加超时(文件内容写时间戳,超过阈值视为失效)。
第二层:超时
每个任务必须有硬超时。没有超时的任务,一旦卡住就会永久占着锁。
const timeout = setTimeout(() => {
  throw new Error('job timeout after 25min')
}, 25 * 60_000)

try {
  await run()
} finally {
  clearTimeout(timeout)
}
超时值怎么定:看历史执行时间的 P99,留 2-3 倍余量。设得太紧会误杀正常任务,太松失去意义。
第三层:多机部署用分布式锁
多台机器都跑 cron 时,锁文件不起作用。用 Redis:
const token = crypto.randomUUID()
const ok = await redis.set(`lock:${name}`, token, 'PX', 30 * 60_000, 'NX')
if (!ok) return { skipped: true }

try {
  await run()
} finally {
  // 只删自己持有的锁,避免删掉别人的
  await redis.eval(
    'if redis.call("get", KEYS[1]) == ARGV[1] then return redis.call("del", KEYS[1]) else return 0 end',
    1, `lock:${name}`, token
  )
}
三个细节容易漏:
NX:不存在才设置,这是互斥的基础;PX:必须有过期时间,否则进程崩溃后锁永不释放;- 删除时校验 token:否则任务超时后锁已过期、被另一个进程拿到,你的
del会误删别人的锁。
更好的架构:调度与执行分离
如果任务数量多,更稳的做法是「单点调度 + 幂等执行」:
- 只有一个调度器(或使用数据库行锁选主),负责决定「该跑了」;
- 执行逻辑写成幂等,重复执行不出错;
- 执行状态落库(
job_runs表),能看到每次的开始时间、结束时间、结果。
状态表的价值在排查时体现:出问题时能直接看出「上一次跑了多久」「是不是重叠了」,而不是靠猜。
幂等比互斥更重要
互斥解决「不要同时跑」,幂等解决「跑了两次也别出错」。
一个清理任务如果写成 DELETE FROM cache WHERE expired_at < now(),重复执行无害,天然幂等。
如果写成 UPDATE counter SET value = value + 1,重复执行就错了。
设计任务时优先考虑幂等:即使锁失效、调度重复、人工重跑,结果都应该一致。这比把锁做得完美更可靠,因为锁总有失效的可能。
监控什么
三个指标:
- 执行时长:突然变长是重叠的前兆;
- 跳过次数:连续跳过说明任务一直没跑完;
- 最后成功时间:超过两个周期没成功,该告警了。
最后一条最实用。与其监控「任务是否报错」,不如监控「任务多久没成功了」——它覆盖了报错、卡死、调度丢失所有情况。
收尾
定时任务的三件套:互斥、超时、幂等。
缺互斥会重叠,缺超时会永久占用,缺幂等会在重试时写坏数据。三个都缺,出事只是时间问题。
再加一条:把「最后成功时间」做成告警指标。这一条能兜住前面所有机制的疏漏。
时间区与夏令时
服务器时区和业务时区不一致,是定时任务另一类高频事故。一个「每天凌晨 2 点」的任务,在 UTC 服务器上实际是北京时间上午 10 点执行。
统一做法:调度器显式指定时区,不要依赖系统默认。cron 表达式里带上 CRON_TZ=Asia/Shanghai,或者用支持时区的调度库,代码里写明。
有夏令时的地区还要注意「跳过的那一小时」和「重复的那一小时」——前者会让任务当天不执行,后者可能执行两次。幂等设计在这里又一次救了命。
你认为这篇文章怎么样?
还没有表情反馈
一起聊聊
一个想法、一点补充,或一句简单的问候。
评论与回复
友善交流,彼此尊重第一句话,留给你。
读完有什么感受?欢迎成为第一个分享的人。