阅读提要
CPU 使用率 90% 但用户毫无感觉,或者 CPU 只有 20% 而接口已经超时——前者说明指标选错了,后者说明你看错了地方。四个信号能把这两件事分开。
为什么是四个
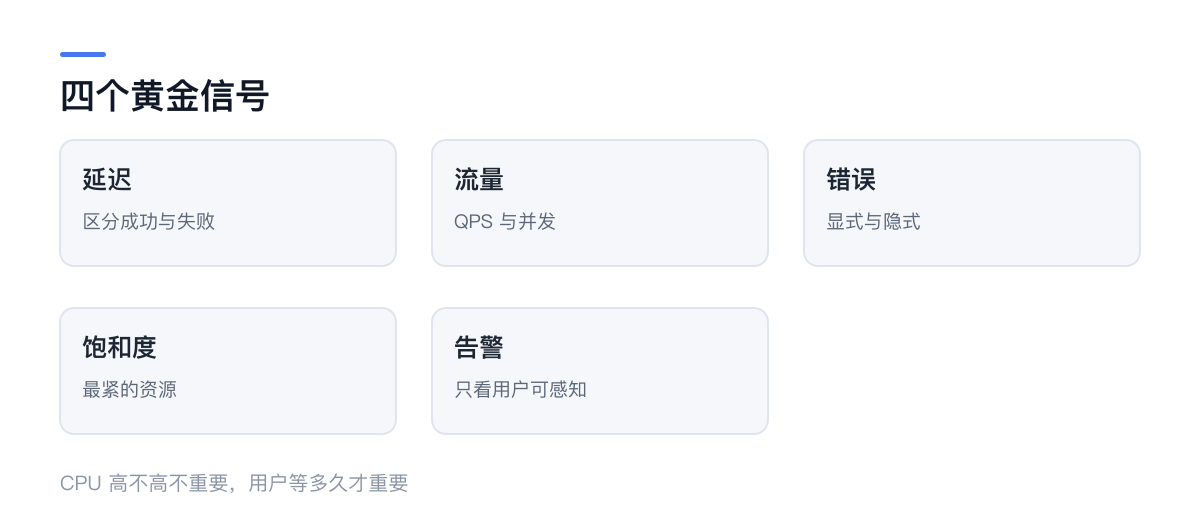
监控指标可以列出一百个,但真正能反映「服务是否健康」的,只需要四类:延迟、流量、错误、饱和度。
这四类覆盖了「用户感受」和「系统承压」两个维度。其他指标(CPU、内存、连接数)都是解释这四类的辅助信息,不是判断依据。
一、延迟:必须区分成功和失败
只统计「平均响应时间」是最常见的错误。一次 30 秒的超时会把平均值拉高,但你看不出「有多少用户在等 30 秒」。
要看分位数:P50、P95、P99。
- P50 反映「典型用户」的体验;
- P95 反映「慢的那部分」;
- P99 反映「最差的那部分」——通常就是抱怨的那批人。
更重要的是把成功和失败的延迟分开:
请求延迟 P99(成功): 240ms
请求延迟 P99(失败): 1.2s
失败请求往往更快(直接拒绝)或更慢(等到超时)。混在一起算,两种异常会互相掩盖。
二、流量:用业务单位,不用请求数
「QPS 5000」这个数字本身没有意义。有意义的是「每秒下单 12 笔」「每分钟登录 300 次」。
业务单位能直接对应到「系统在承载多少真实工作」。请求数会骗人——一次页面加载可能发 40 个请求,其中 35 个是静态资源。
按接口分别统计更好:
/api/posts       QPS 120
/api/comments    QPS 8
/api/auth/login  QPS 3
流量分布能立刻告诉你哪条路径最关键。优化时优先看 QPS 高且 P99 高的那几条。
三、错误:显式的和隐式的
显式错误是 5xx、异常、连接失败。容易采集。
隐式错误是「返回 200 但内容是错的」:业务错误码、空数据、降级响应。这类更危险,因为监控看不出来。
{ "code": 50001, "message": "库存不足" }HTTP 200,业务失败。如果只按状态码统计,这类错误完全隐形。
实践做法:在应用层定义「业务成功率」,和 HTTP 成功率并列监控。
还有一类:部分失败。一个页面 5 个数据块,1 个失败了,页面仍然返回 200。用户看到的是残缺的页面。这类要在前端上报。
四、饱和度:最紧的那个资源
饱和度衡量「资源还有多少余量」。关键是找对资源。
- CPU 密集型服务:CPU 使用率;
- I/O 密集型服务:磁盘 IOPS、网络带宽;
- 数据库:连接池使用率、慢查询数;
- 内存敏感的:内存使用率、GC 时间占比;
- 有队列的:队列长度。
看错了资源,会出现「CPU 只有 20% 但服务已经崩了」——因为瓶颈在连接池。
判断方法:压测时逐步加压,看哪个指标先撞墙。那个就是你的关键饱和度指标。
告警该基于什么
不要基于资源告警,要基于用户可感知的现象告警。
- ❌ CPU > 80% 告警:夜里跑批时天天响,然后所有人开始忽略告警;
- ✅ P99 延迟 > 1s 持续 5 分钟:用户真的在等;
- ✅ 错误率 > 1% 持续 3 分钟:用户真的在失败;
- ✅ 最后成功时间超过阈值:任务真的没跑。
资源指标适合放在看板上观察趋势,不适合做告警条件。
告警的三条纪律:能行动、有分级、会过期。每条告警都应该对应一个明确的处理动作;P0 叫醒人,P2 进工单;长期不响的告警要删掉。
一个最小可用的看板
一屏能看完的四块:
- 请求量(按接口 top 5)
- P50/P95/P99 延迟(成功与失败分开)
- 错误率(HTTP + 业务)
- 关键饱和度(连接池、队列长度)
再加一行「最近部署时间」——把发布事件标在时间轴上,能立刻看出「是不是刚发版导致的」。
这一条极其有用,因为它把「什么时候开始坏的」和「什么时候做了什么」直接对上了。
收尾
四个信号的价值不在指标本身,在于它们强制你回答四个问题:
- 用户等多久?(延迟)
- 系统在做什么?(流量)
- 有多少人在失败?(错误)
- 还剩多少余量?(饱和度)
四个都答得上来,监控就算及格了。
指标之外:日志与链路
四个信号回答「有没有问题」,回答不了「为什么」。后者需要日志和调用链。
日志负责单点的细节:某个请求在某个时刻发生了什么。调用链负责跨服务的时序:一次请求在五个服务里各花了多久。
三者配合的方式是:看板上发现 P99 异常 → 拉出慢请求的 trace → 定位到具体服务 → 用 trace id 去查该服务的日志。
缺任何一环,排查就会断在中间。只有指标,你知道「慢了」但不知道「慢在哪」;只有日志,你不知道「有多少人在受影响」。
采样率要设对
全量采集 trace 的成本在小流量站点可以接受,流量上来之后必须采样。
常见策略是「头部采样」:进入系统时就决定采不采,按 1% 或 10% 的比例。简单,但会漏掉罕见错误——错误率本来就只有千分之一,采样后就看不见了。
更好的做法是「尾部采样」:先全部收集,请求结束后根据结果决定是否保留。慢请求和失败请求全留,正常请求只留 1%。成本可控,异常不丢。
这个策略需要缓冲整条链路的数据,实现复杂度高一些,但对排查的价值大得多。
你认为这篇文章怎么样?
还没有表情反馈
一起聊聊
一个想法、一点补充,或一句简单的问候。
评论与回复
友善交流,彼此尊重第一句话,留给你。
读完有什么感受?欢迎成为第一个分享的人。