阅读提要
大多数人对 Git 的理解停留在「命令背下来了」。理解四种对象和引用之后,rebase、reset、cherry-pick 都不再需要背,因为你能推出来。
从 .git 目录说起
一个 Git 仓库里真正重要的东西只有三样:对象库、引用、索引。其余全是缓存和配置。
对象库在 .git/objects,键是内容的 SHA-1(新版可选 SHA-256),值是压缩后的对象。引用在 .git/refs 和 .git/packed-refs,索引在 .git/index。
理解了这个结构,git commit 做了什么就很清楚了:它没有「保存修改」,它新建了几个对象,然后移动了一个指针。
四种对象
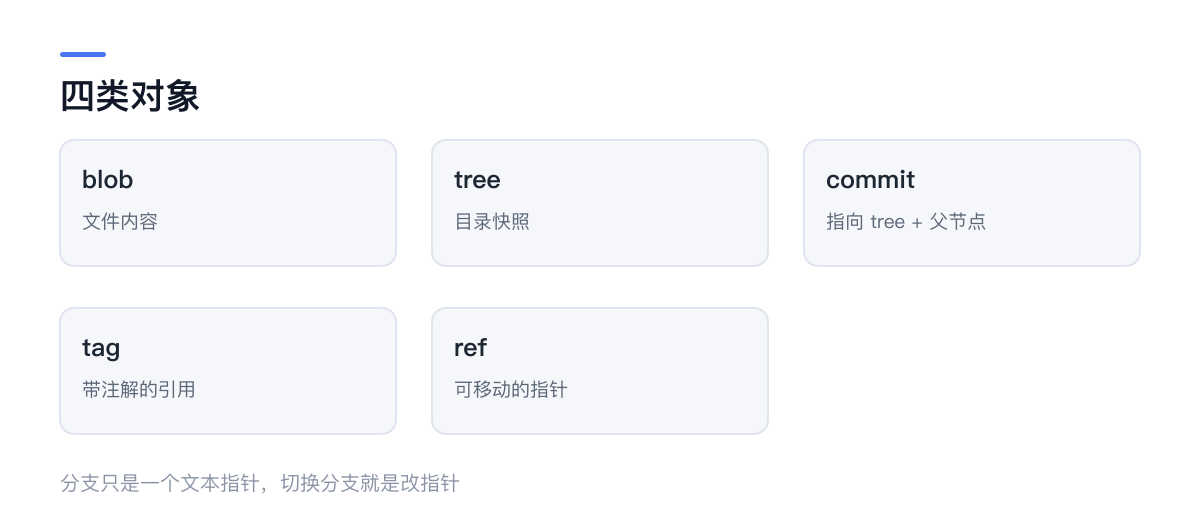
blob:文件内容。只有字节,没有文件名,没有权限。两个内容相同的文件共用一个 blob。
tree:一层目录。它记录「名字 → 对象 ID」的映射,包括子目录(指向另一个 tree)和文件(指向 blob),还带权限位。
commit:一个 tree 的 ID + 父 commit 的 ID + 作者信息 + 提交信息。它不包含任何文件内容,只是一个「快照指针 + 历史链接」。
tag:带注解的引用,比 commit 多一段签名和信息。
用命令看一遍最直观:
git cat-file -p HEAD
# tree 4b825dc...
# parent 8a1f0c...
# author ...

git cat-file -p HEAD^{tree}
# 100644 blob abc123...    README.md
# 040000 tree def456...    src
分支为什么那么便宜
cat .git/refs/heads/main
# 8a1f0c7e...
分支就是一个 41 字节的文本文件,里面是一个 commit 的 SHA。创建分支 = 写一个文件,切换分支 = 改一个文件 + 更新工作区。
所以「分支很重」是 SVN 时代留下的错觉。在 Git 里,分支的代价基本可以忽略,这也是为什么「每个功能开一个分支」在 Git 工作流里是默认做法。
HEAD 是一个特殊的引用,通常指向某个分支(ref: refs/heads/main),处于分离头指针状态时直接指向 commit。
reset、revert、cherry-pick 的本质
理解了对象,这三个命令就是几何操作:
reset --soft:只移动当前分支指针,索引和工作区不动。相当于「撤销上一次 commit,改动还留着」。
reset --mixed(默认):移动指针 + 重置索引,工作区不动。改动变成未暂存。
reset --hard:移动指针 + 重置索引 + 覆盖工作区。改动丢失。
三者区别只是「动到哪一层」。而 reset 之后的旧 commit 并没有被删除——它还在对象库里,只要记得 SHA,用 git reflog 就能找回来。所以「reset 把代码弄丢了」通常不是真丢,是不知道去哪找。
revert 是新建一个 commit,内容是「反向应用某个 commit 的改动」。它不移动指针,所以可以安全地用在已经推送的分支上。
cherry-pick 是把某个 commit 的 diff 应用到当前分支,然后新建一个 commit。新 commit 的父节点是当前 HEAD,不是原 commit 的父节点——所以 SHA 一定不同。
rebase 为什么会冲突
rebase 的本质是:找到两个分支的共同祖先,把当前分支上的每个 commit 依次「重新应用」到目标分支上。
每个 commit 都要重新计算 diff 并应用,所以:
- 冲突是正常的,因为基础变了;
- 每个 commit 都会生成新的 SHA,历史被重写;
- 已经推送并被别人拉取的分支不要 rebase——他们本地的历史会对不上。
理解第 2 点,就能理解为什么 rebase 之后 git push 需要 --force-with-lease。
一个实用的排查动作
线上出问题,想确认某个文件在哪个 commit 被改坏:
git log -p --follow -- path/to/file.js
git blame path/to/file.js
blame 显示的是「这一行最后一次被哪个 commit 修改」。它不是追责工具,是理解代码来由的工具——看到一行奇怪的判断,blame 到对应的 commit message,往往就能明白当时的上下文。
收尾
Git 的命令很多,但底层只有四类对象和两种引用。遇到不懂的命令,问三个问题:
- 它动了对象库,还是只动了引用?
- 它改了工作区吗?
- 它重写历史吗(即:别人的仓库会不会对不上)?
答完这三个,绝大多数「危险操作」的风险等级就清楚了。
packfile:为什么 .git 没那么大
如果每个版本都完整存一份文件,仓库会迅速膨胀。Git 用 packfile 解决:把相似对象打包,用增量存储 + zlib 压缩。
git gc            # 手动触发打包
git count-objects -vH这就是为什么一个有几万次提交的仓库,.git 可能只有几十 MB。
理解这一点的实际意义:删除大文件后,仓库体积不会立刻变小,因为旧对象还在 packfile 里。要真正清理,得用 git filter-repo 重写历史,然后强制推送——这会改变所有 commit 的 SHA,团队所有人都要重新克隆。
你认为这篇文章怎么样?
还没有表情反馈
一起聊聊
一个想法、一点补充,或一句简单的问候。
评论与回复
友善交流,彼此尊重第一句话,留给你。
读完有什么感受?欢迎成为第一个分享的人。