阅读提要
大多数排查失败不是因为技术不够,是因为顺序错了——先猜原因再找证据,于是找到的都是支持自己猜测的证据。
一个典型的错误开场
线上报错,第一反应是「肯定是缓存的问题」,然后开始翻缓存代码。翻了半小时,没找到问题,但已经投入了半小时,于是继续翻。
这是排查中最常见的陷阱:先有假设,再找证据。人会不自觉地只看见支持假设的信息。
正确的顺序是反过来的:先固定现象,再缩小范围,最后才提假设。
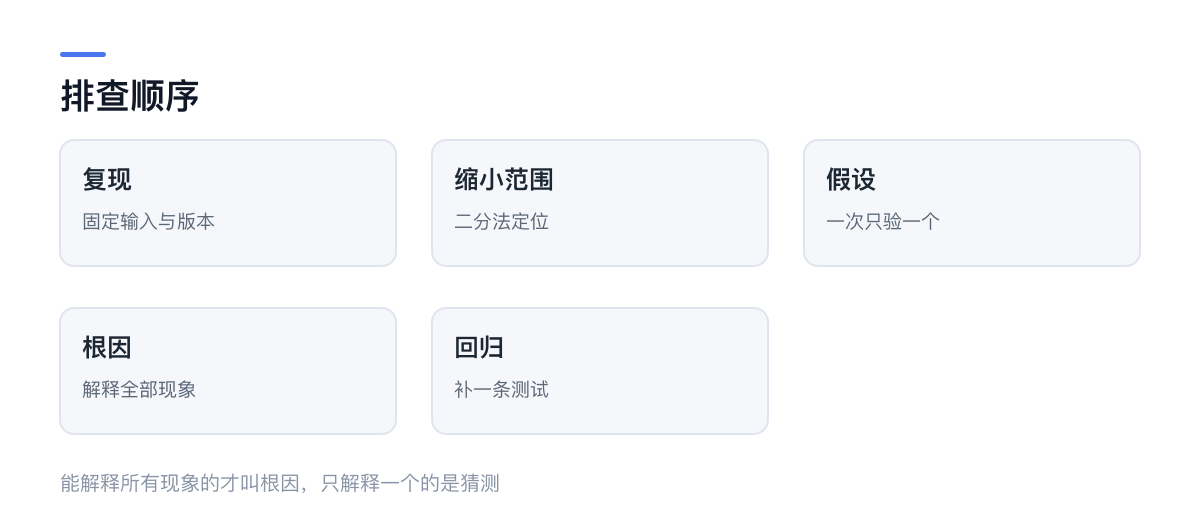
第一步:复现,把现象钉死
不能复现的问题,基本无法可靠修复。
复现需要固定四件事:
- 输入:什么请求、什么参数、什么数据;
- 版本:哪个 commit、哪个配置;
- 环境:浏览器/系统/网络/数据量;
- 频率:必现还是偶发,偶发的概率多少。
「偶发」这个词最危险。它通常意味着「有并发」「有时序」「有边界条件」,而这三类问题的排查方法完全不同。
实用的做法是记录完整的请求 ID,把所有相关日志串起来。如果日志里没有请求 ID,那第一步应该是加上它。
第二步:缩小范围,用二分法
不要从头读到尾,用二分。
按层二分:是前端、网络、应用、还是数据库?
- 直接
curl接口,绕开前端 → 排除 UI; - 在应用层打日志,看请求到了没 → 区分网络与应用;
- 看 SQL 执行时间 → 区分应用与数据库。
按版本二分:上个版本正常吗?git bisect 能自动定位到具体 commit。
按数据二分:某个用户有问题,其他用户正常吗?如果是,问题在数据不在代码。
每一次二分都应该排除一半的可能性。如果排查了两小时,可能性只减少了一点点,说明方法不对。
第三步:一次只验一个假设
有了几个候选原因,不要同时改三处再测——如果好了,你不知道是哪一处起的作用;如果没好,三处都要回滚。
正确做法:提出假设 → 设计一个能证伪的实验 → 执行 → 观察。
「能证伪」很关键。比如怀疑缓存,不是「去看缓存代码」,而是「清掉缓存再试一次」——如果问题消失,假设成立;如果还在,假设被排除。
这个动作花 30 秒,比读半小时代码有效。
第四步:根因必须解释所有现象
一个假设如果只能解释部分现象,那它最多是「次要原因」,不是根因。
比如「接口慢」,可能的解释有:数据库慢、网络抖动、GC 停顿、连接池排队。如果只解释了「偶尔慢」,但没解释「为什么总是在整点前后」,那就还没找到根因。
检验方法:用根因反推所有观察到的现象。推不出来,就继续找。
这条标准能防止「找到一个能改的地方就停下来」——很多时候改完只是让症状消失了,问题还在。
第五步:修完补一条测试
修完不补测试,同一个 bug 会以另一种形式回来。
测试要针对根因,不是针对症状:
// ❌ 只测了这次的具体输入
test('3 个用户时不出错', ...)

// ✅ 测了根因对应的规则
test('并发注册时用户名唯一约束生效', ...)
五个常见的思维陷阱
确认偏误:只找支持自己猜测的证据。解法是主动找「能推翻假设」的实验。
沉没成本:在一个方向上投入了半小时,就不愿意换方向。解法是设定时间盒——20 分钟没进展就换一条路径。
归因于外部:「肯定是网络问题」「肯定是用户操作不对」。外部因素确实存在,但先证明内部没问题,再归因外部。
忽略时间线:「什么时候开始坏的」和「那段时间改了什么」,这两个信息能解决一半的问题。发布记录、配置变更、数据量突变,都要对照。
一次改多处:同时改三个地方,然后「好了」。下次再出问题,你没有任何可复用的知识。
一个实用的话术
排查时对外沟通,不要只说「在查」,要说清楚:
- 现在的现象是什么(影响多少用户);
- 已经排除了哪些可能(缩小到什么范围);
- 下一步计划验证什么;
- 预计什么时候能给结论。
这套话术的价值是:让别人能帮你判断,也避免自己被「马上就好」的乐观情绪带偏。
收尾
排查能力的差别,不在于谁更懂某个框架,而在于是否按顺序走。
固定现象 → 缩小范围 → 单点验证 → 解释全部 → 补测试。
五步走完,即使没找到答案,你也知道问题不在哪几个地方——这本身就是进展。
工具解决的是「看见」,方法解决的是「想清楚」
调试器、日志、抓包工具都很重要,但它们只帮你获得信息,不帮你做判断。
一个常见的误区是:遇到问题先打开调试器单步走。对逻辑错误有用,对性能问题、并发问题、环境问题基本无效——因为这类问题的信息不在调用栈里。
选工具的判断标准是:这个问题是「代码执行路径不明」还是「系统状态异常」。前者用调试器,后者用日志、指标、抓包。
把结论写下来
排查结束后,花十分钟写一段记录:现象、排查路径、根因、修复方式、以及「下次遇到类似现象先看哪里」。
这段记录的价值在下一次故障时体现。团队里如果每个人都有这样的记录,故障平均恢复时间会明显下降——因为大部分故障是重复出现的,只是表现不同。
别在深夜做大改动
状态不好的时候,人会倾向于「先改一下看看」。这类改动通常没有记录,几轮之后,你已经分不清哪些是原有代码、哪些是自己加的。
排查期间的所有改动都要记录下来,哪怕只是加一行日志。结束时统一回滚,不要留下「反正也没影响」的临时修改——它们会在半年后变成没人敢动的谜团。
你认为这篇文章怎么样?
还没有表情反馈
一起聊聊
一个想法、一点补充,或一句简单的问候。
评论与回复
友善交流,彼此尊重第一句话,留给你。
读完有什么感受?欢迎成为第一个分享的人。