阅读提要
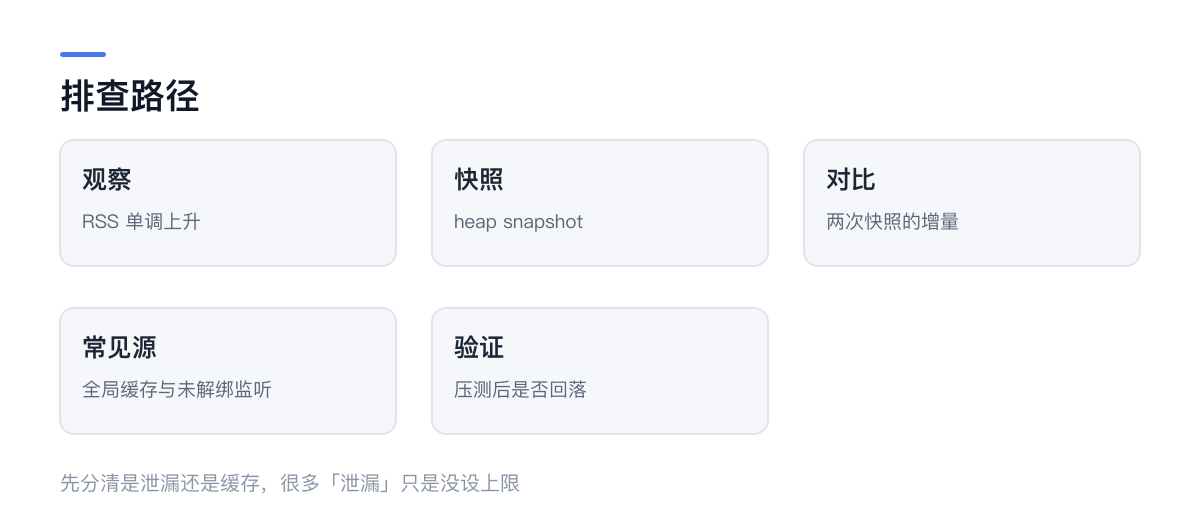
进程内存一路上涨、重启就好、过几天又涨——先分清是「泄漏」还是「缓存没上限」。这篇给出从观察到定位的完整路径。
先分清两件事
看到 RSS 上涨,第一反应是「内存泄漏」。但实际情况分两类:
一类是真泄漏:对象被不该持有的引用链挂着,GC 永远回收不掉。
另一类是缓存没上限:对象确实还有用,只是你忘了设淘汰策略。
第二类更常见,也更好修。判断方法:重启后内存回落到基线,然后缓慢上升到某个值后稳定——这是缓存;一直上升到 OOM——这是泄漏。
第一层:确认是堆还是堆外
ps -o rss= -p <pid>RSS 是操作系统看到的总内存,包含堆、堆外(Buffer、C++ 对象)、以及共享库。
再看堆:
setInterval(() => {
  const m = process.memoryUsage()
  console.log({
    rss: (m.rss / 1e6).toFixed(0),
    heapUsed: (m.heapUsed / 1e6).toFixed(0),
    external: (m.external / 1e6).toFixed(0),
    arrayBuffers: (m.arrayBuffers / 1e6).toFixed(0)
  })
}, 30_000)
如果 heapUsed 稳定而 rss 一直涨,问题在堆外——最常见的是 Buffer 没释放,或者 sharp、better-sqlite3 这类原生模块的对象没被正确回收。
如果 heapUsed 一直涨,才是典型的 JS 堆泄漏。
第二层:两次快照对比
node --inspect server.js
# 或者给运行中的进程发信号
kill -USR2 <pid>
用 Chrome DevTools 连上(chrome://inspect),在 Memory 面板拍两次快照,间隔几分钟,选择「Comparison」视图。
看 Delta 列排序:增长最多的构造函数就是嫌疑对象。
常见结果:
Array增长巨大 → 某个全局数组一直 push;Closure增长 → 事件监听器没解绑;Map/Set增长 → 缓存没淘汰;- 业务对象(如
User)增长 → 某处把对象挂在全局了。
第三层:五类常见泄漏
1. 全局缓存无上限
const cache = new Map()
function get(key, load) {
  if (!cache.has(key)) cache.set(key, load(key))
  return cache.get(key)
}
请求参数一多,这个 Map 会无限增长。修法是加 LRU 上限,或者用 WeakMap(键是对象时)。
2. 事件监听器累积
// 每次请求都加一个监听
req.on('close', () => cleanup())单次请求没问题,但如果监听加在长生命周期的对象上(process、server、全局 EventEmitter),就会累积。Node 默认在超过 10 个监听时警告 MaxListenersExceededWarning——这个警告不要忽略。
3. 定时器没清
function poll() {
  const timer = setInterval(fetchData, 1000)
  // 忘了 clearInterval
}
定时器持有回调,回调持有作用域,作用域持有大量对象。一个没清的 interval 能拖住几十 MB。
4. 闭包持有大对象
function createHandler(bigData) {
  return () => console.log(bigData.length)   // 一直持有 bigData
}
只要 handler 活着,bigData 就回收不掉。解法是在用完的地方把它置空,或者只提取需要的字段。
5. Buffer 切片
const chunk = bigBuffer.slice(0, 100) // 共享底层内存slice 不复制数据,返回的视图持有整个 bigBuffer。100 字节的视图让 10MB 的 Buffer 无法回收。用 Buffer.from(bigBuffer.subarray(0, 100)) 复制一份。
定位之后怎么验证
改完不要急着上线。用压测验证:
- 记录改前的基线(跑 1 小时,内存曲线);
- 改后同样压测;
- 对比「稳态内存」和「是否回落」。
稳态内存下降 = 有效;压测结束后能回落到基线 = 真修好了;仍然单调上升 = 还有别的地方。
预防手段
- 给所有缓存设上限,哪怕是「绝对不会超」的缓存;
- 给每个
setInterval配一个clearInterval,写在同一个函数里; - 长生命周期对象的监听器要成对出现(on/off 写在一起);
- 线上开启
--max-old-space-size,让泄漏表现成可观测的重启,而不是拖垮整台机器; - 加一条内存告警:RSS 超过阈值持续 10 分钟就通知。
最后一条最实用。等用户反馈「服务变慢」时,往往已经泄漏几天了。
收尾
内存问题排查的顺序是:先分清堆内堆外,再对比快照,最后对照五类常见模式。
顺序错了会浪费很多时间——比如对着堆外的问题翻 JS 代码,怎么都找不到。
你认为这篇文章怎么样?
还没有表情反馈
一起聊聊
一个想法、一点补充,或一句简单的问候。
评论与回复
友善交流,彼此尊重第一句话,留给你。
读完有什么感受?欢迎成为第一个分享的人。