阅读提要
接口突然从 40ms 变成 1.2s,慢查询日志里没有一条超过 20ms 的 SQL。N+1 的特征是「数量」而不是「单条耗时」,用错了工具就会找不到。
现象
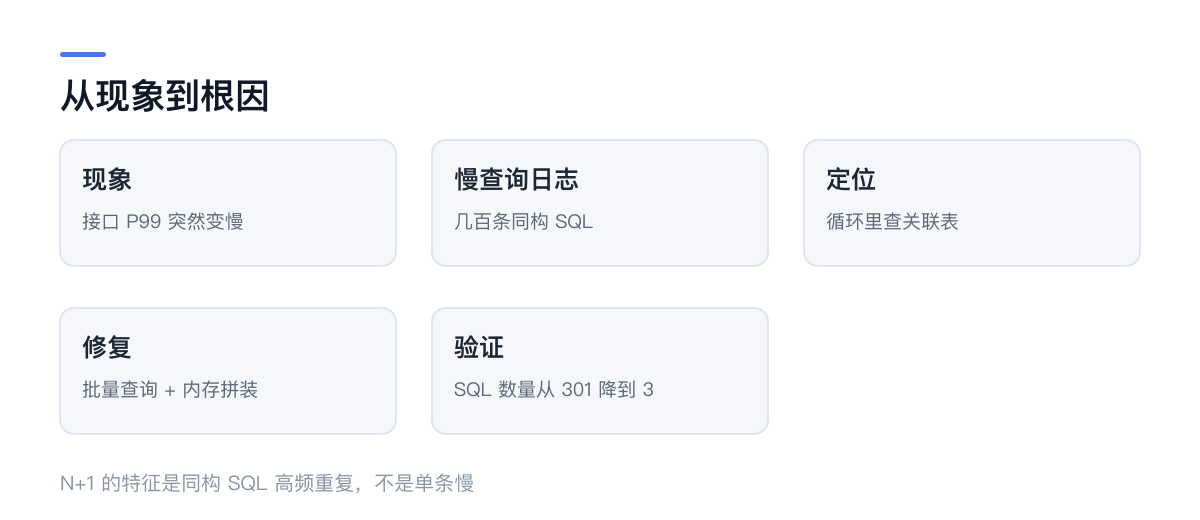
一个列表接口,平时 P99 是 40ms。某天开始变成 1.2s,错误率没变,CPU 没飙,数据库连接数也没涨。
慢查询日志里最长的一条是 18ms——完全正常。这就是 N+1 的迷惑之处:每一条 SQL 都很快,但它们被执行了 300 次。
第一步:数 SQL,而不是看 SQL
先确认假设:把一次请求内的 SQL 全部打出来数一遍。
// 临时打开查询计数
let count = 0
db.on('query', () => { count++ })
或者在应用层加一个统计:一次请求结束打印 { path, duration, sqlCount }。
结果:/api/posts 一次请求执行了 301 条 SQL。列表 1 条,剩下 300 条是每篇文章查一次标签。
结论立刻清楚:不是数据库慢,是往返次数太多。300 次网络往返,即使每次 1ms,也是 300ms 起步;加上连接池排队,1.2s 完全合理。
第二步:找到循环
const posts = await db.select().from(postsTable).limit(30)
for (const post of posts) {
  post.tags = await db.select().from(tags).where(eq(tags.postId, post.id))
}
典型的循环内查询。ORM 的「懒加载」特性最容易制造这个问题——写起来像访问属性,实际每次都发一次 SQL。
第三步:改成批量
两种思路。
一次查完,内存里分组:
const posts = await db.select().from(postsTable).limit(30)
const ids = posts.map(p => p.id)
const allTags = await db.select().from(tags).where(inArray(tags.postId, ids))

const grouped = new Map()
for (const tag of allTags) {
  const list = grouped.get(tag.postId) ?? []
  list.push(tag)
  grouped.set(tag.postId, list)
}
for (const post of posts) post.tags = grouped.get(post.id) ?? []
SQL 数量从 301 降到 2。
或者用一次 JOIN:
SELECT p.*, t.id AS tag_id, t.name AS tag_name
FROM posts p
LEFT JOIN post_tags pt ON pt.post_id = p.id
LEFT JOIN tags t ON t.id = pt.tag_id
WHERE p.status = 'published'
ORDER BY p.published_at DESC
LIMIT 30
JOIN 只发一条 SQL,但结果集会有重复行(一篇文章 N 个标签就有 N 行),需要在应用层折叠。数据量大时,传输量反而更高。
怎么选:一对多且子项数量少,用 IN + 分组;需要按子项排序或过滤,用 JOIN。
第四步:验证
改完再数一次:sqlCount 从 301 变成 2,P99 从 1.2s 回到 45ms。
这一步不能省。很多优化「感觉快了」,但没有数据支撑,下次 review 时没人能判断该不该保留。
为什么压测没发现
常见原因:压测数据只有 5 篇文章。
N+1 的耗时与列表长度成正比。测试库 5 条数据,多查 5 次,感知不到;生产 300 条,就是 300 次。所以压测数据量必须接近生产,否则这类问题一定漏。
另一个原因:本地数据库没有网络延迟。localhost 上 300 次查询可能只要 30ms,跨机房就是 300ms。
这类问题的通用识别信号
- 接口耗时随「返回条数」线性增长;
- 慢查询日志看起来很干净;
- 数据库 QPS 很高但单条都很短;
- CPU 不高,但响应时间上去了(在等 I/O)。
四条里中两条,基本可以怀疑 N+1。
怎么从源头避免
ORM 层面:关掉懒加载,或者显式要求「预加载关联」。多数 ORM 提供 with、include、preload 之类的接口,用它而不是访问属性触发查询。
代码层面:任何在 for 或 map 里出现 await db. 的地方,都要停下来想一秒。这一条规则能挡住 90% 的 N+1。
监控层面:给每个接口记录 SQL 数量,设一个阈值告警(比如单请求超过 50 条)。这个指标比耗时更早发现问题。
收尾
N+1 不是「SQL 写得不好」,是「调用次数失控」。所以排查工具不是慢查询日志,是查询计数器。
记住了这一点,下次再遇到「接口慢但数据库很闲」,第一反应就对了。
缓存也会掩盖问题
加了 Redis 缓存之后,N+1 的耗时被缓存命中掩盖了。一旦缓存大面积失效(重启、过期),请求会瞬间打回原形,甚至更糟——因为此时数据库要同时承受 N 倍的查询。
所以「加了缓存之后不慢了」不等于问题解决了。判断方法很简单:清空缓存再压测一次。如果耗时暴涨,说明底层还有结构性问题。
你认为这篇文章怎么样?
还没有表情反馈
一起聊聊
一个想法、一点补充,或一句简单的问候。
评论与回复
友善交流,彼此尊重第一句话,留给你。
读完有什么感受?欢迎成为第一个分享的人。