阅读提要
流式渲染不会让页面变快,它只是把「能看见」的时间点提前。理解 TTFB、FCP 和 hydration 的关系,才知道什么时候值得上流式。
传统 SSR 在等什么
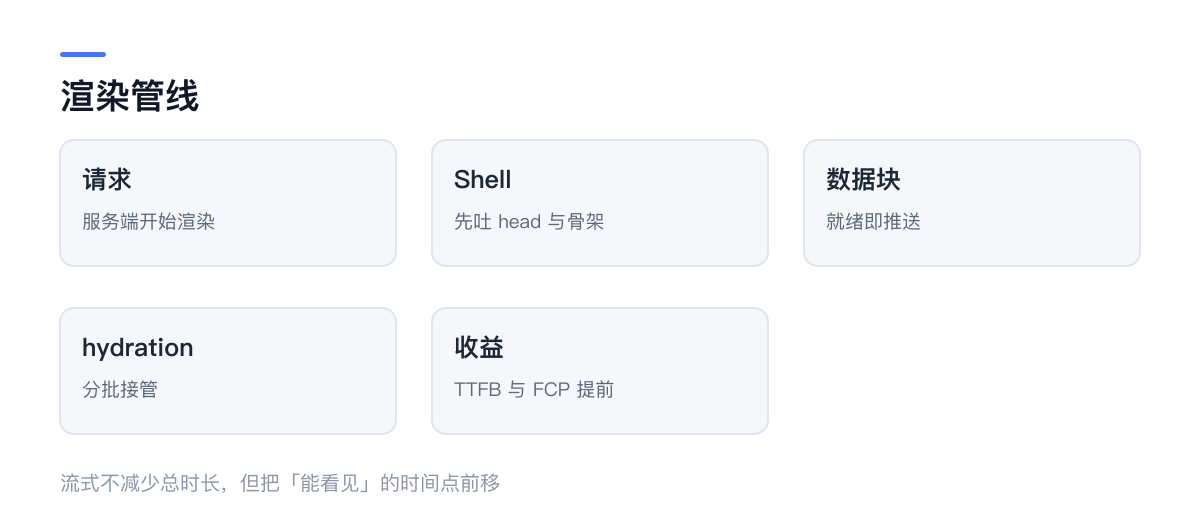
一次 SSR 请求的流程是:路由匹配 → 拉数据 → 渲染整棵组件树 → 拼成完整 HTML → 一次性返回。
问题在「拉数据」这一步。首页可能要查文章列表、热门、分类、公告,四个请求串行或并行,最慢的那个决定整体时间。假设最慢 800ms,用户在这 800ms 里看到的是白屏。
流式渲染改的是这个顺序:先把不需要数据的壳吐出去,数据好了再把对应片段推过去。
三个指标的分工
- TTFB(首字节时间):服务器开始返回第一个字节的时间;
- FCP(首次内容绘制):浏览器画出第一块内容的时间;
- TTI(可交互时间):JS 加载完、页面能响应操作的时间。
流式渲染优化的是 TTFB 和 FCP,对 TTI 基本没有帮助——因为 JS 还是要下载完才能交互。
这一点必须说清楚:流式不是「让页面更快」,是「让用户更早看到东西」。心理感受的提升是真实的,但总加载时间没变。
实现方式
在 React 里是 renderToPipeableStream + Suspense;在 Vue/Nuxt 里是 Suspense 组件 + 服务端流式渲染。
核心结构:
<template>
  <AppHeader />
  <Suspense>
    <ArticleList />
    <template #fallback>
      <ListSkeleton />
    </template>
  </Suspense>
</template>
服务端渲染到 Suspense 边界时,如果数据没好,先输出 fallback 的 HTML,然后继续渲染后面的部分。数据就绪后,通过一段内联脚本把对应 DOM 替换掉。
浏览器不需要等整页,先画出头部和骨架,用户立刻有反馈。
代价一:不能再设 Content-Length
流式响应用 chunked 传输,无法预先知道总长度。这意味着:
- 某些老代理会缓冲整个响应再转发,流式优势归零(Nginx 需要
proxy_buffering off); - CDN 可能不支持流式回源;
Content-Length相关的进度条逻辑失效。
上线前必须确认链路上的每一层都支持流式,否则代码改了、效果没有。
代价二:错误处理变复杂
传统 SSR 出错,可以返回一个 500 页面。流式渲染已经开始输出了,此时出错只能在流里插入一段错误提示,HTTP 状态码仍然是 200。
这会导致监控失真:状态码全是 200,但页面其实是错的。所以流式场景下,必须用「页面内错误标记」而不是状态码来做告警。
代价三:hydration 更麻烦
流式输出的片段是分批到达的,React 需要在客户端按顺序 hydrate。如果某个 Suspense 边界后来又变了(比如用户点了按钮),可能出现 hydration mismatch。
实践中的规则:Suspense 边界内的内容,在首次 hydration 完成前不要依赖客户端状态。依赖了,就会出现「服务端渲染的和客户端算出来的不一致」。
什么情况下不值得上流式
- 数据请求很快(< 100ms):流式的收益被复杂度吃掉;
- 页面很小:一次返回几 KB,分块传输没有意义;
- 链路上有缓冲代理又改不动:纯属白做;
- 团队没有对应的监控能力:出了问题看不出来。
反过来,这些情况值得:
- 首屏有多个独立数据源,最慢的那个明显拖后腿;
- 页面结构清晰,能明确划分「壳」和「内容区」;
- 有 CDN 且支持流式回源;
- 用户主要在移动网络下访问(首字节时间的收益更明显)。
一个务实的中间方案
如果不想引入流式的复杂度,可以先做两件事,收益接近:
一是骨架屏。服务端先返回带骨架的 HTML,客户端拿到数据后填充。用户看到的是「结构先出现」,心理等待时间大幅下降。
二是关键数据优先。把首屏必须的数据和次要数据分开请求,先渲染主内容,侧栏和推荐位延后。
这两个方案不需要改渲染管线,风险低,多数场景够用。流式是在这之上进一步榨取 TTFB 的手段,不是必需品。
收尾
判断要不要上流式,问一句:首屏白屏的那几百毫秒,是不是主要卡在数据上?
是,流式有意义;不是(卡在 JS 体积、字体、图片),那先解决那些,收益大得多。
与缓存的配合
流式响应和 HTTP 缓存天然不兼容:内容在生成中就开始输出,无法计算 ETag,也无法预知总长度。
所以流式页面通常要设 Cache-Control: no-store 或很短的时间。这意味着每次请求都要真渲染一次——对高流量站点,源站压力会明显上升。
常见折中是:首屏流式,其余页面用缓存。首页承担体验,列表页和详情页走缓存承担容量。
另一个思路是把流式的「块」做成可缓存的单元:页头页脚是静态的,数据块单独请求并缓存。这样既保留了「先看见」的体验,又不至于每次全量渲染。
一个容易忘的降级
流式渲染依赖浏览器渐进解析 HTML。如果中间有代理做了缓冲,用户看到的效果和传统 SSR 一样——只是慢一点,不会坏。
真正会坏的是错误处理:流已经开始输出,此时出错无法改状态码。所以每个 Suspense 边界都要有独立的错误回退,不能指望全局错误页——那个页面已经来不及发出了。
你认为这篇文章怎么样?
还没有表情反馈
一起聊聊
一个想法、一点补充,或一句简单的问候。
评论与回复
友善交流,彼此尊重第一句话,留给你。
读完有什么感受?欢迎成为第一个分享的人。