阅读提要
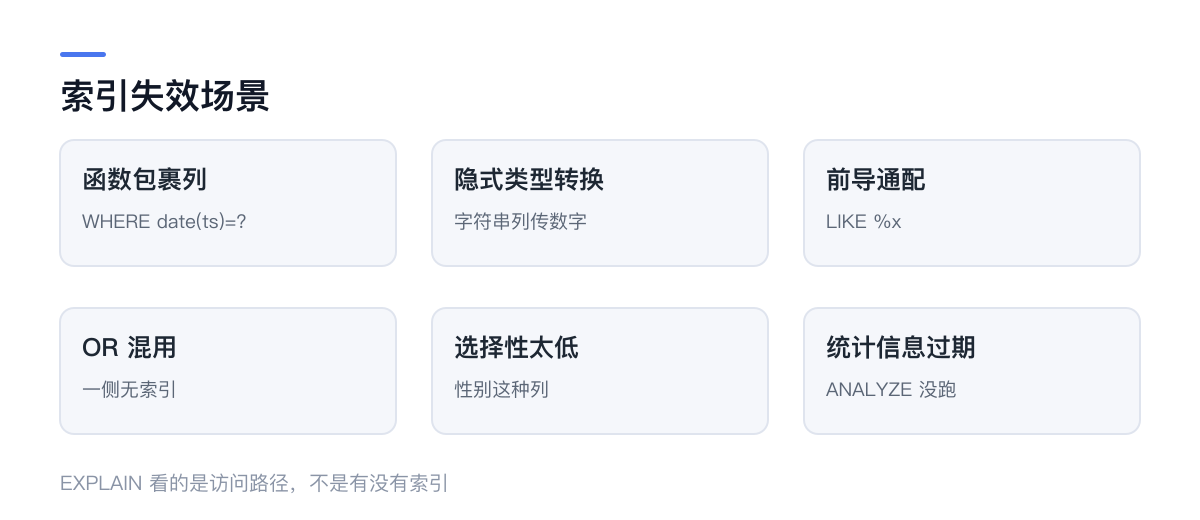
「我建了索引为什么还是慢」——因为索引存在不等于被使用。这七种写法会让优化器直接放弃索引,而且都不会报错。
先学会看执行计划
判断索引有没有被用,唯一可靠的方法是看执行计划:
EXPLAIN QUERY PLAN
SELECT * FROM posts WHERE date(published_at) = '2026-11-01';
-- SCAN posts           ← 全表扫描,索引没用上
SCAN 是全表扫描,SEARCH ... USING INDEX 才是走索引。SQLite、MySQL、PostgreSQL 的语法不同,但都有对应命令。
看到 SCAN 再来找原因,比凭感觉猜有效得多。
一、列被函数包裹
-- 索引失效
WHERE date(created_at) = '2026-11-01'

-- 改成范围查询,索引可用
WHERE created_at >= '2026-11-01' AND created_at < '2026-11-02'
索引存的是列的原值。一旦对列做函数运算,数据库必须对每一行算一遍才能比较,索引自然用不上。
同理的还有 substr()、lower()、CAST()。要按大小写不敏感搜索,正确做法是建函数索引或加一个规范化列,而不是在查询里套函数。
二、隐式类型转换
-- phone 是 TEXT 列,传入数字
WHERE phone = 13800138000
MySQL 会把列转成数字再比较,索引失效。PostgreSQL 直接报类型错误(这反而更好,早发现)。
统一原则:查询参数的类型必须和列定义一致。前端传来的都是字符串,写后端时要显式转换,不要依赖数据库的隐式规则。
三、前导通配符
WHERE title LIKE '%关键词'B-Tree 索引按前缀排序,前缀不确定就无法定位起点。LIKE '关键词%' 可以用索引,%关键词 不行。
真要支持全文搜索,用 FTS(SQLite 的 FTS5、MySQL 的 FULLTEXT、PostgreSQL 的 tsvector),而不是在 B-Tree 上碰运气。
四、OR 连接的一侧没有索引
WHERE status = 'published' OR author_id = 5即使 status 有索引,author_id 没有,优化器也可能整体退化成全表扫描。
解法:给两个字段都建索引,或者改写成 UNION:
SELECT ... WHERE status = 'published'
UNION
SELECT ... WHERE author_id = 5
五、复合索引的顺序不对
复合索引 (a, b, c) 遵循最左前缀原则。WHERE b = 1 用不上这个索引,WHERE a = 1 AND c = 2 只能用到 a。
设计复合索引时,把选择性最高、最常用于等值查询的列放前面。
另一个细节:范围查询会截断后面的列。WHERE a > 1 AND b = 2 只能用到 a,b 用不上。所以等值条件放前面,范围条件放后面。
六、选择性太低
给 status(只有 published/draft 两个值)建索引,查询 90% 的行都是 published 时,优化器会判断「走索引再回表」比「直接全表扫」更慢,于是主动放弃。
这不是 bug,是优化器的正确判断。低选择性列单独建索引几乎没意义,除非和别的列组成复合索引。
七、统计信息过期
优化器靠统计信息估算行数。数据大批量增删后,统计信息没更新,估算严重偏差,就会选错执行计划。
ANALYZE;                    -- SQLite
ANALYZE TABLE posts;        -- MySQL
定时跑一次 ANALYZE,成本很低。遇到「昨天还快今天就慢」且 SQL 没改的情况,先怀疑这个。
还有一种:索引太多
索引不是越多越好。每个索引都会拖慢写入,还会占空间。一张表建十几个索引,写性能可能下降一半。
判断标准:每个索引都应该对应一个真实的查询模式。没人用的索引,删掉。
排查顺序
遇到慢查询,按这个顺序走:
EXPLAIN看是不是全表扫描;- 是 → 检查上面七种情况;
- 不是全表扫描但还慢 → 看回表次数、排序、临时表;
- 都正常 → 可能不是索引问题,是数据量或网络。
第 3、4 步经常被跳过,导致「加了索引还是慢」的困惑。索引只解决「怎么找到行」,不解决「找到之后怎么处理」。
收尾
索引失效的共同点是:让数据库无法用「有序性」来定位数据。函数、类型转换、前导通配、OR、顺序错误,破坏的都是同一件事。
理解了这一点,不用背七条规则也能推出来。
覆盖索引:不用回表的那一步
普通索引查到主键后,还要回表读整行。如果查询需要的列都在索引里,数据库可以直接从索引返回,省掉回表。
CREATE INDEX idx_posts_list ON posts(status, published_at, title);
SELECT title, published_at FROM posts WHERE status = 'published' ORDER BY published_at DESC;
这条查询完全走索引,不回表。对列表页这种「只取少数几列」的场景,收益非常明显。
代价是索引变大、写入变慢。所以覆盖索引要针对具体的高频查询设计,不要试图覆盖所有列——那等于把整张表复制一份。
你认为这篇文章怎么样?
还没有表情反馈
一起聊聊
一个想法、一点补充,或一句简单的问候。
评论与回复
友善交流,彼此尊重第一句话,留给你。
读完有什么感受?欢迎成为第一个分享的人。