阅读提要
用流处理大文件,代码看起来只有三行,但背压、错误传播和资源清理三件事一旦漏掉,就是内存暴涨和句柄泄漏。这篇把三个坑逐个拆开。
为什么不能一次读进内存
读一个 2GB 的日志文件做筛选,最直觉的写法是 fs.readFileSync。它在小文件上没问题,在大文件上有两个后果:一是 V8 的字符串上限(约 512MB)直接抛错,二是就算没超限,进程常驻内存也会飙到几个 GB,容器被 OOM Kill。
流把「一次读完」换成「一次读一块」。默认块大小 64KB,内存占用恒定,与文件大小无关。
但这只是起点。真正的麻烦从第二行代码开始。
第一道坎:背压
流有两种速度:可读流的产出速度和可写流的消费速度。当写入端跟不上,数据会在内存里堆积——这就是背压。
Node 的流内置了背压机制:write() 返回 false 时,表示内部缓冲区已超过 highWaterMark,你应该暂停读取,等 drain 事件再继续。
用 pipe() 或 pipeline() 时,这件事是自动的。手写 on('data') 处理时,就不是了:
// 错误示范:完全不理会背压
readable.on('data', chunk => {
  writable.write(transform(chunk))   // 返回值被忽略
})
正确写法是:
readable.on('data', chunk => {
  if (!writable.write(transform(chunk))) {
    readable.pause()
    writable.once('drain', () => readable.resume())
  }
})
这段代码的意思是「写不动就先别读」。看起来很啰嗦,所以更好的选择是下面这条。
第二道坎:错误传播
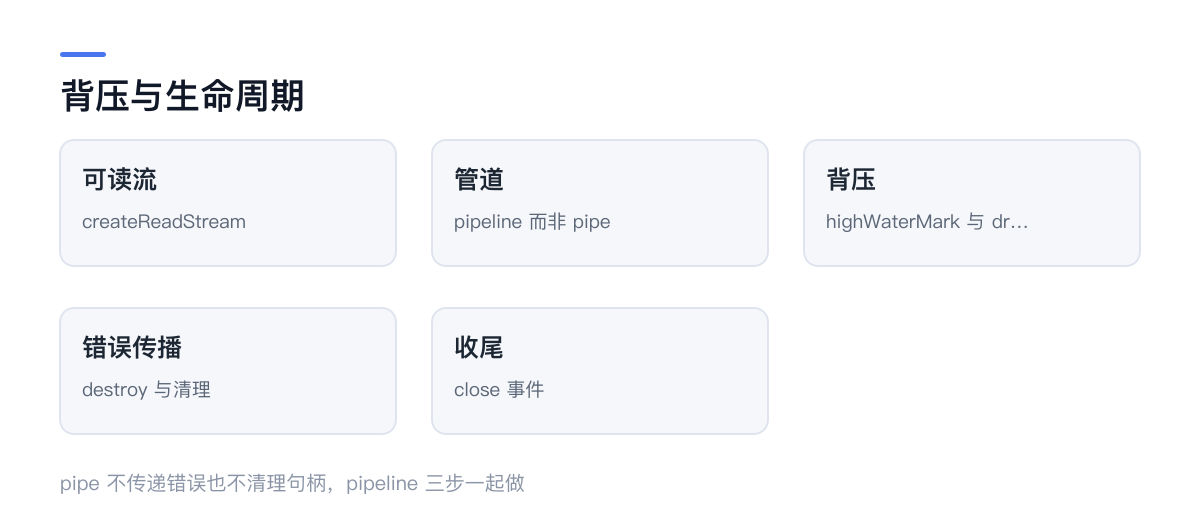
pipe() 只做数据搬运,不做错误处理。中间任何一个环节出错,pipe 不会通知其他环节,源流继续读,目标流可能已经关闭,结果是句柄泄漏 + 进程挂住。
pipeline() 解决了这个问题:
import { pipeline } from 'node:stream/promises'
import { createReadStream, createWriteStream } from 'node:fs'
import { createGzip } from 'node:zlib'

await pipeline(
  createReadStream('access.log'),
  createGzip(),
  createWriteStream('access.log.gz')
)
pipeline 做三件事:串联背压、任一环节出错时销毁全部流、全部完成后返回。用 await 还能让错误自然进入 try/catch。
这是 Node 官方推荐的写法,没有理由再用 pipe 串多级。
第三道坎:收尾
流结束不等于文件写完。createWriteStream 在 finish 事件之后还有一个 close,此时文件描述符才真正释放。
pipeline 会等到 close,手写的话要自己监听。更隐蔽的问题是:出错时你有没有 destroy()?一个没被销毁的流会一直占着 fd,跑几千次就撞上 EMFILE: too many open files。
// 手写版本必须保证异常路径也清理
try {
  await pipeline(readable, writable)
} catch (error) {
  readable.destroy()
  writable.destroy()
  throw error
}
用 pipeline 时这一步是自动的,这也是它值得用的主要理由之一。
一个真实的组合场景
需求:把 8GB 的 JSON Lines 文件按字段拆分,过滤后写出。
import { createReadStream, createWriteStream } from 'node:fs'
import { createInterface } from 'node:readline'
import { pipeline } from 'node:stream/promises'
import { Transform } from 'node:stream'

const filter = new Transform({
  objectMode: true,
  transform(line, _enc, callback) {
    try {
      const row = JSON.parse(line)
      if (row.level === 'error') callback(null, `${line}\n`)
      else callback()
    } catch {
      callback()   // 坏行直接跳过,不要让它中断整个任务
    }
  }
})

await pipeline(
  createReadStream('app.jsonl'),
  createInterface({ crlfDelay: Infinity }),
  filter,
  createWriteStream('errors.jsonl')
)三个细节值得注意:crlfDelay: Infinity 让 Windows 换行也能正确分行;解析失败时 callback() 而不是 callback(err),避免一行坏数据毁掉整个任务;objectMode 让 Transform 以行为单位而不是以字节块为单位工作。
判断标准
写流式代码时问自己三个问题:
- 内存占用是否与文件大小无关?(
process.memoryUsage().rss观察) - 中途抛错时,所有流都被销毁了吗?(看 fd 数量)
- 结束之后,文件是真的写完了吗?(
close而非end)
三个都答得上来,这段代码才算合格。否则在小文件上测试一切正常,上线遇到大文件才开始出事。
你认为这篇文章怎么样?
还没有表情反馈
一起聊聊
一个想法、一点补充,或一句简单的问候。
评论与回复
友善交流,彼此尊重第一句话,留给你。
读完有什么感受?欢迎成为第一个分享的人。