阅读提要
很多人把 journal_mode=WAL 当成一个「开了就快」的开关,但它真正改变的是并发模型。搞清楚它解决了什么、又付出了什么代价,才知道什么时候该开、什么时候不能开。
先看默认模式卡在哪里
SQLite 默认使用 rollback journal。一次写事务开始时,它先把要修改的页复制到 -journal 文件,再改主库。这个设计保证了原子性,代价是写事务期间整个数据库被独占:别的写进不来,读也要等。
对一个单用户的桌面应用,这没什么感觉。但只要你的服务有并发——比如首页要读文章列表,后台同时在保存草稿——就会出现两种典型症状:读请求偶发变慢,写请求偶发报 database is locked。
这不是 SQLite 慢,是它在用最保守的方式保证一致性。
WAL 改的是什么
WAL(Write-Ahead Logging)把「改主库」拆成两步:先顺序追加到 -wal 文件,等某个时刻再统一回写主库。这一步改动带来三个直接结果。
第一,写不再覆盖原有页。原来的数据还在主库文件里,新数据在 WAL 尾部。读事务按自己的快照去读,读到的是旧版本,不会被打断。
第二,读写可以真正并发。写事务往 WAL 追加,读事务读主库 + WAL 里的快照,两者互不阻塞。这是 WAL 最核心的收益。
第三,提交变快了。顺序追加比随机写页便宜得多,尤其在没有掉电保护的机械盘上。
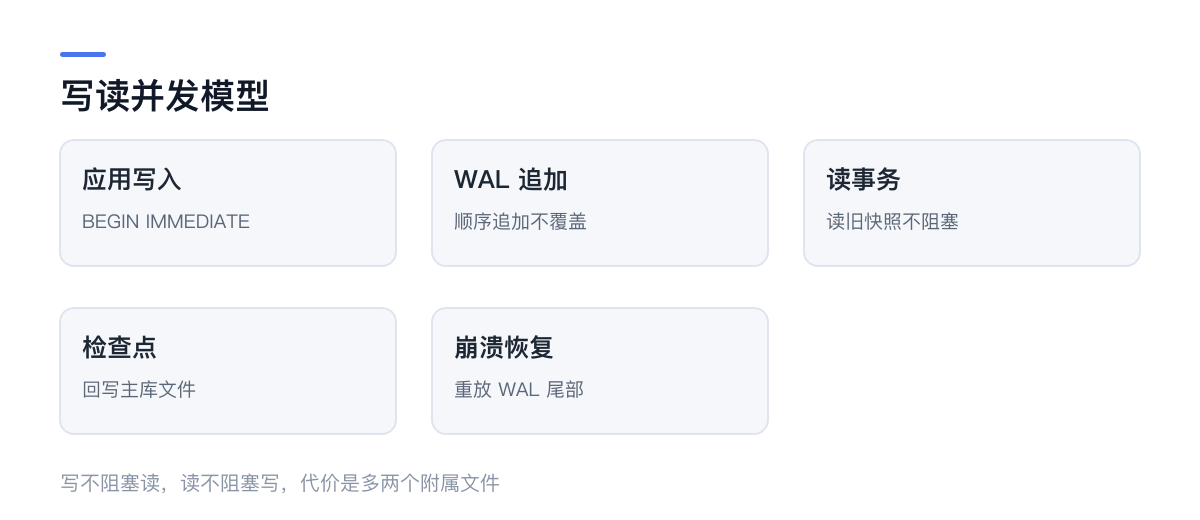
代价也很具体:多了 -wal 和 -shm 两个文件,检查点(checkpoint)会成为新的性能变量,备份和复制必须把它们当成数据库的一部分。
怎么开,开到什么程度
切换模式只需要一句:
PRAGMA journal_mode = WAL;这是持久化设置,写进数据库头,重启后仍然有效。但它只是模式,真正决定「一次提交有多稳」的是 synchronous:
-- 默认,每次提交都 fsync,最安全
PRAGMA synchronous = FULL;

-- WAL 下推荐的折中:提交不 fsync,检查点才 fsync
PRAGMA synchronous = NORMAL;
NORMAL 在 WAL 下的语义是:正常关机不丢数据,突然断电可能丢掉最近若干次提交,但数据库不会损坏。对博客、笔记这类应用,这个取舍通常是可以接受的;对记账、订单,老老实实用 FULL。
还有一个容易被忽略的参数:
PRAGMA wal_autocheckpoint = 1000; -- 每 1000 页触发一次检查点WAL 文件不会自己变小。如果写入量很大而检查点跟不上,-wal 会一直长,直到把磁盘吃满。默认 1000 页(约 4MB)是个合理起点,但长事务会阻止检查点推进——一个开了不提交的读事务,能让 WAL 无限增长。
四个真正会踩的坑
1. 网络文件系统上不要用。 WAL 依赖共享内存(-shm),NFS、SMB、部分容器卷不支持 mmap 共享,轻则退化成只读,重则数据损坏。SQLite 官方对此的措辞是「不支持」,不是「性能差」。
2. 备份必须带上 -wal。 直接 cp blog.db 会拿到一个缺少最新提交的旧库。正确做法是用 backup API,或者先 PRAGMA wal_checkpoint(TRUNCATE) 再复制。这也是为什么很多「备份完恢复丢数据」的案例,根因在备份脚本而不是数据库。
3. 长时间读事务会拖住检查点。 一个忘记提交的 BEGIN 会让 WAL 无法回收。设置 PRAGMA busy_timeout = 5000 能让写操作等一会儿而不是立刻报错,但治不了长事务。
4. 多进程写仍然是串行的。 WAL 允许一写多读,不允许多写。两个进程同时写,还是只有一个能成功,另一个拿到 SQLITE_BUSY。
什么情况下不该开
- 数据库放在网络盘或跨主机共享卷上;
- 一次性批量导入大量数据,之后只读——此时 WAL 的检查点反而添乱,导完再切回来更干净;
- 需要把单个
.db文件拷来拷去当分发物(比如随应用打包的种子库),多两个附属文件会让流程变复杂。
其余情况,尤其是「一个进程、有并发读写」的服务,WAL 基本是默认该开的选项。
一句话总结
WAL 不是在优化速度,它是在用「多两个文件 + 检查点」换「读写不互相阻塞」。理解这句话,参数就不会乱调:synchronous 决定你能承受丢多少,wal_autocheckpoint 决定 WAL 能长多大,busy_timeout 决定冲突时是等还是报错。
什么时候该做检查点
自动检查点由写入量触发,默认每 1000 页。但有一类场景需要手动干预:批量导入之后。
一次导入十万行,WAL 会迅速长大到几百 MB。虽然自动检查点最终会回收,但在那之前,磁盘占用和读性能都会受影响。导入结束后手动执行一次:
PRAGMA wal_checkpoint(TRUNCATE);TRUNCATE 会把 WAL 截断回零长度,比默认的 PASSIVE 更彻底。前提是没有活跃的读事务,否则会返回 busy。
配套的监控很简单:定期看 -wal 文件大小。它长期超过几十 MB,说明检查点跟不上写入,要么调小 wal_autocheckpoint,要么找出那个忘了提交的事务。
你认为这篇文章怎么样?
还没有表情反馈
一起聊聊
一个想法、一点补充,或一句简单的问候。
评论与回复
友善交流,彼此尊重第一句话,留给你。
读完有什么感受?欢迎成为第一个分享的人。